
PerfectScale
Commitments sind ein bewegliches Ziel. Native Recommender verfehlen es – also haben wir unseren eigenen gebaut.
AWS und Google Cloud liefern die richtige Zahl. Wir auch. Und dann gehen wir noch einen Schritt weiter.
Diese Seite ist auch in English, Español, Français, Italiano, 日本語 und Português verfügbar.


About Mohammad Reza Saleh Sedghpour
Senior Software Engineer 2
Mohammad Reza Saleh Sedghpour is a Senior Software Engineer II at DoiT and a Cloud Engineer and Researcher with over a decade of experience in cloud computing and distributed systems. He holds a Ph.D. in Computer Science, specializing in resiliency patterns for microservices, and is an active open-source contributor who regularly publishes research and presents at international conferences. At DoiT, he works on the automation behind cloud cost-optimization tooling, including commitment management — helping businesses use cloud technologies for optimal performance, resilience, and cost.
My personal pageCommitments gehören zu den schnellsten Hebeln, um Kosten auf der Cloud-Rechnung zu senken. Sie Woche für Woche richtig zu dimensionieren, ist allerdings ein Vollzeitjob.
Wenn wir PerfectScale for Commitments einem FinOps Engineer zeigen, kommt deshalb fast jedes Mal dieselbe Frage auf.
"AWS sagt mir doch schon, wie viel ich committen soll. Google Cloud auch. Wozu brauche ich euren?"
Berechtigt. Ehrlich gesagt ist es genau die richtige Frage. Beide Clouds liefern einen Recommender mit. Beide sind kostenlos. Und beide sind korrekt – für die Frage, für die sie gebaut wurden.
Also haben wir das Naheliegende getan und unseren Recommender parallel zu ihren laufen lassen. Monatelang. Gleiche Accounts, gleiche Zeiträume, gleiche Commitment-Typen, kein Rosinenpicken. Dieser Beitrag ist das Ergebnis.
Die Kurzfassung: Wer dieselbe Frage stellt, bekommt dieselbe Zahl. Alles Interessante steckt in dem, was diese Zahl umgibt. Wie oft Sie fragen dürfen. Was Sie vor dem Fragen anpassen können. Ob Ihnen jemand sagen kann, warum. Und ob eine Maschine um 3 Uhr nachts ohne Sie auf die Antwort reagieren kann.
Wie unsere Engine die Zahl findet
Eigentlich sind es zwei Engines. Eine für AWS Savings Plans, eine für Google Cloud Committed Use Discounts (CUDs). Getrennter Code, denn die beiden Clouds bepreisen und verrechnen Commitments auf wirklich unterschiedliche Weise – das zu ignorieren, hätte uns Genauigkeit gekostet. Die Grundidee ist aber dieselbe.
Alles beginnt mit rohen Nutzungsdaten. Wir nehmen jede einzelne Stunde an Ausgaben, die ein Commitment im Lookback-Zeitraum abdecken könnte – bei einem 60-Tage-Fenster sind das rund 1.440 einzelne Stunden mit ihren exakten Beträgen. Manche dieser Stunden sind randvoll. Andere sind komplett tot, vor allem wenn das Wochenendtief zuschlägt. Die eigentliche Herausforderung ist, mit dieser stark schwankenden Kurve umzugehen.
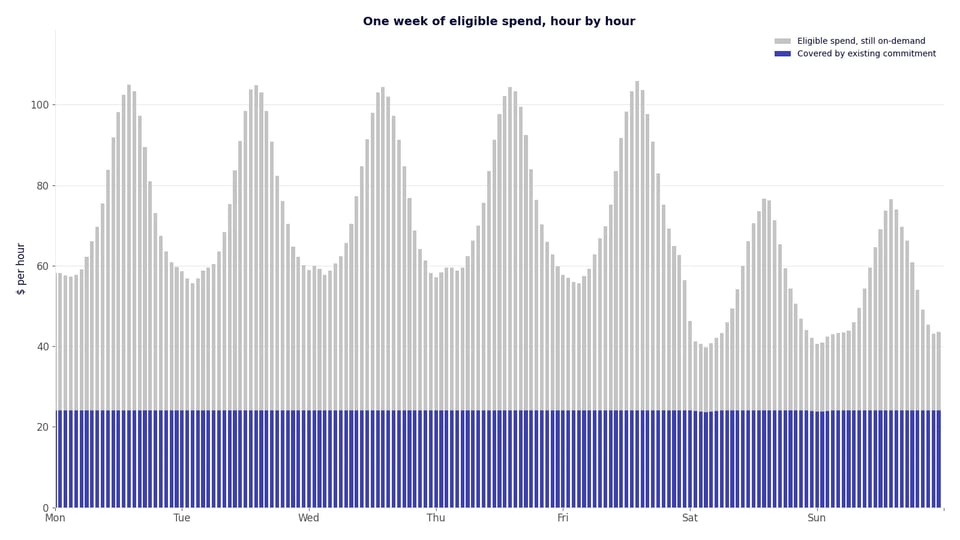
Dann ziehen wir ab, was Sie bereits besitzen. Haben Sie aktive Savings Plans oder CUDs, wenden wir sie auf jede Stunde genauso an wie der Cloud-Anbieter: bester Rabatt zuerst. Was diese Pläne bereits abdecken, ist aus dem Spiel. Übrig bleiben die Ausgaben, bei denen ein neues Commitment noch Geld sparen könnte.
Wir berücksichtigen außerdem jeden Rabatt, den Sie bereits haben. Verhandelte Vertragspreise. Sustained-Use-Rabatte auf Google Cloud. Abdeckung durch DoiT Flexsave, falls Sie es nutzen. Ein Commitment lohnt sich nur, wenn es den Preis schlägt, den Sie heute tatsächlich zahlen – also vergleichen wir gegen genau diesen Preis, nicht gegen den Listenpreis.
Die beiden Engines sind getrennt, weil AWS und Google Cloud Abrechnungsdaten unterschiedlich bereitstellen und Commitments nach eigenen Regeln verrechnen. Das Prinzip ist aber dasselbe: Das Commitment wird gegen das gerechnet, was Sie tatsächlich zahlen – nicht gegen einen Listenpreis, der nie auf Ihrer Rechnung auftaucht.
Jetzt kommt der entscheidende Teil.
Nehmen Sie ein beliebiges stündliches Commitment, das Sie kaufen könnten. Über das Zeitfenster zahlen Sie zwei Dinge: das Commitment selbst, jede einzelne Stunde, genutzt oder nicht. Plus die On-Demand-Ausgaben, die in den Spitzenstunden noch darüber hinauslaufen. Beides zusammen ergibt Ihre Gesamtkosten bei diesem Commitment-Level.
Ein kurzes Beispiel. Eine Stunde hat 100 $ anrechenbare Ausgaben, und Sie haben – der Einfachheit halber – 30 $ pro Stunde bei 40 % Rabatt committet. Diese 30 $ decken 50 $ On-Demand-Nutzung ab. Sie zahlen also 30 $ für das Commitment, 50 $ On-Demand für den Rest, insgesamt 80 $ statt 100 $. Gut. Jetzt eine ruhige Stunde mit nur 40 $ anrechenbaren Ausgaben. Ihre 30 $ decken weiterhin 50 $ ab, nur gibt es bloß 40 $ zu decken. Sie zahlen 30 $, sparen 10 $, und ein Teil des Commitments liegt einfach brach. Der Recommender rechnet das für jede Stunde im Fenster durch und summiert alles auf. Dann macht er dasselbe für jedes Commitment-Level, das er empfehlen könnte, um zu sehen, welches am meisten spart.
Trägt man diese Gesamtkosten gegen die Höhe des Commitments auf, entsteht eine Schüsselkurve. Der tiefste Punkt der Schüssel ist der Sweet Spot: das Commitment, bei dem Ihre Gesamtrechnung am niedrigsten ist.
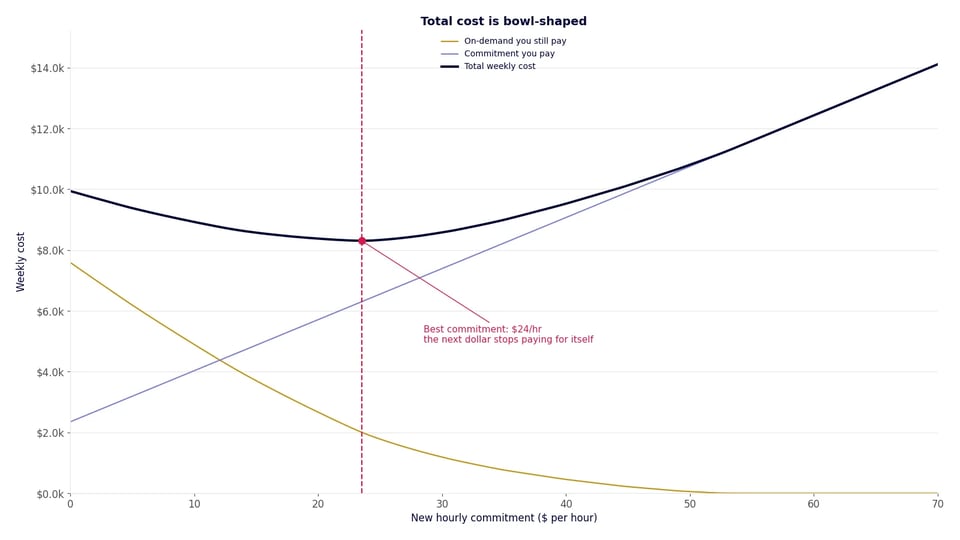
Auf der linken Seite haben Sie zu wenig committet. Jeder zusätzliche Commitment-Dollar ersetzt mehr als einen Dollar On-Demand-Ausgaben, die Gesamtkosten sinken also. Auf der rechten Seite haben Sie zu viel committet. Zusätzliches Commitment liegt in ruhigen Stunden brach, die Gesamtkosten steigen wieder.
Der tiefste Punkt der Schüssel ist der Punkt, an dem ein weiterer committeter Dollar mehr kosten würde, als er spart. Das ist das beste Commitment. Wir suchen es nicht, indem wir jeden Wert Cent für Cent durchprobieren und den günstigsten behalten. Die Form der Kurve verrät uns, wo sie kippt – also springen wir direkt zu diesem Punkt.
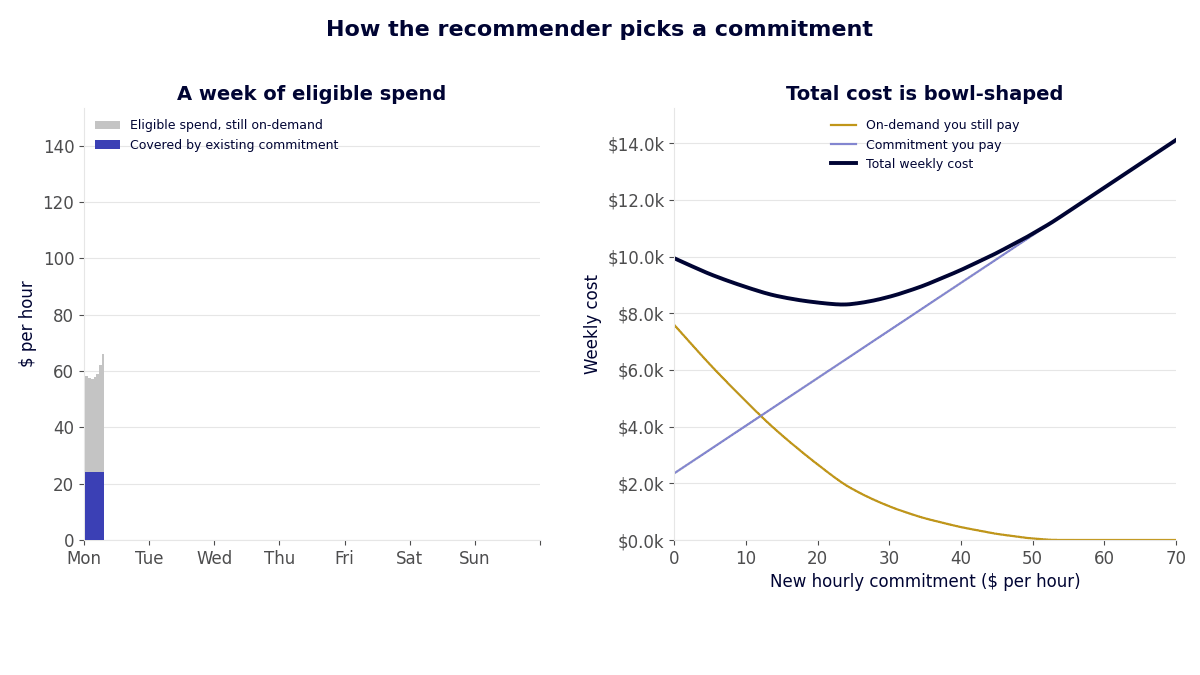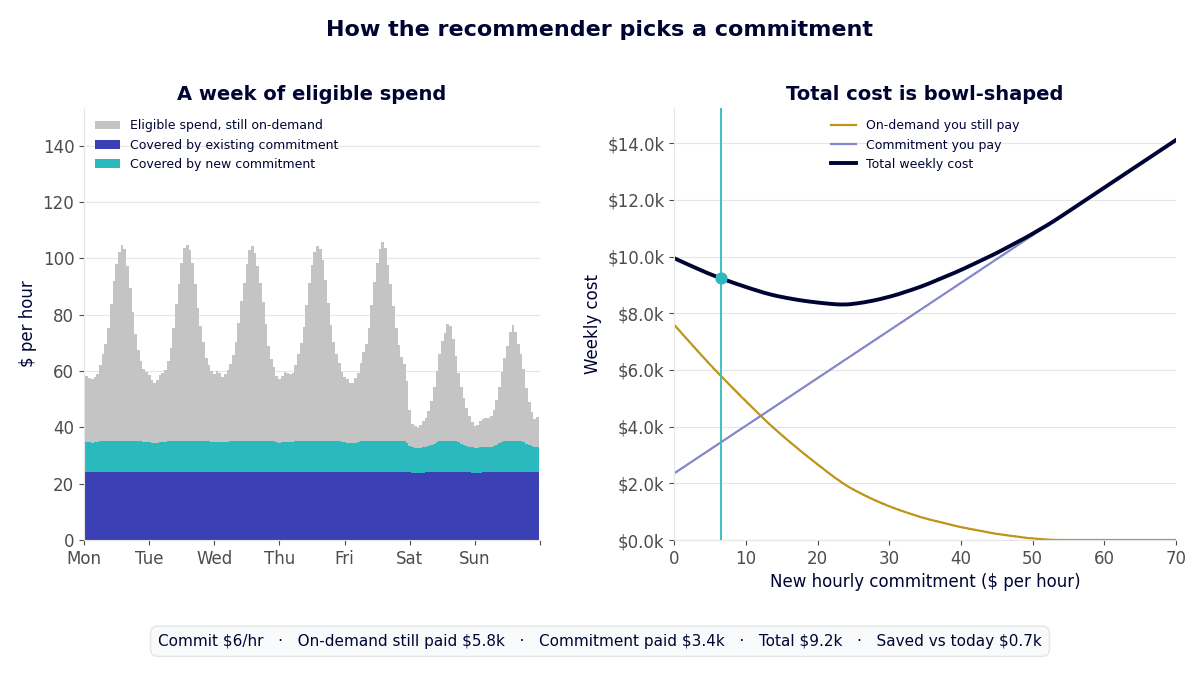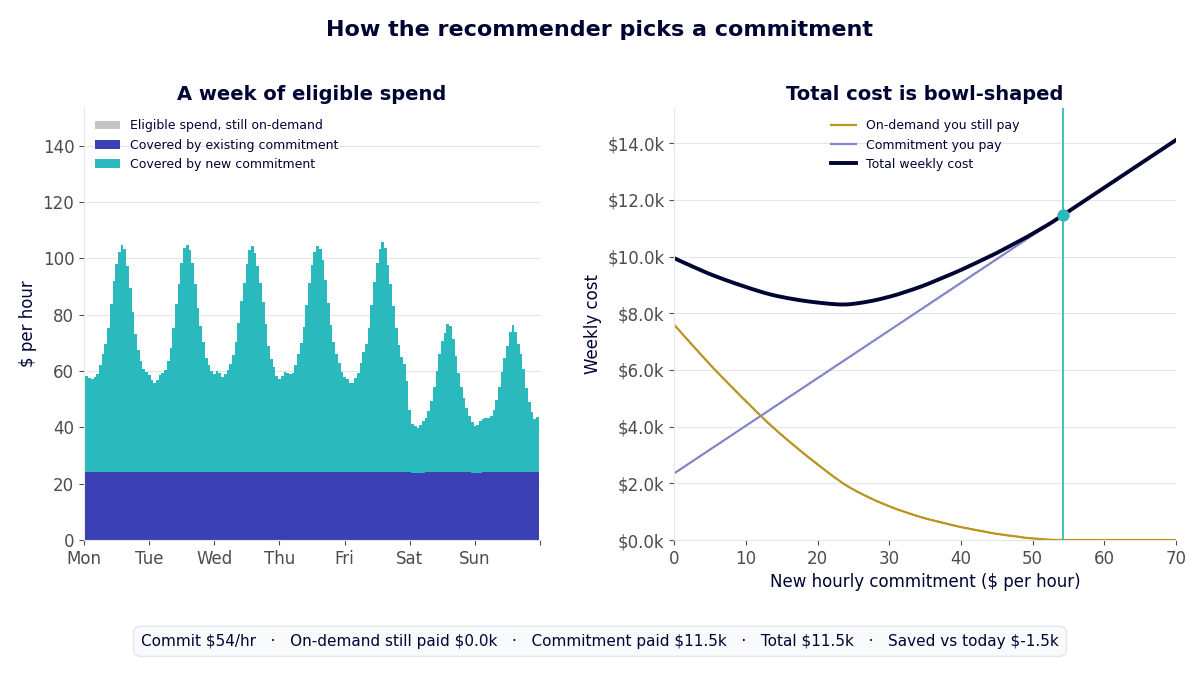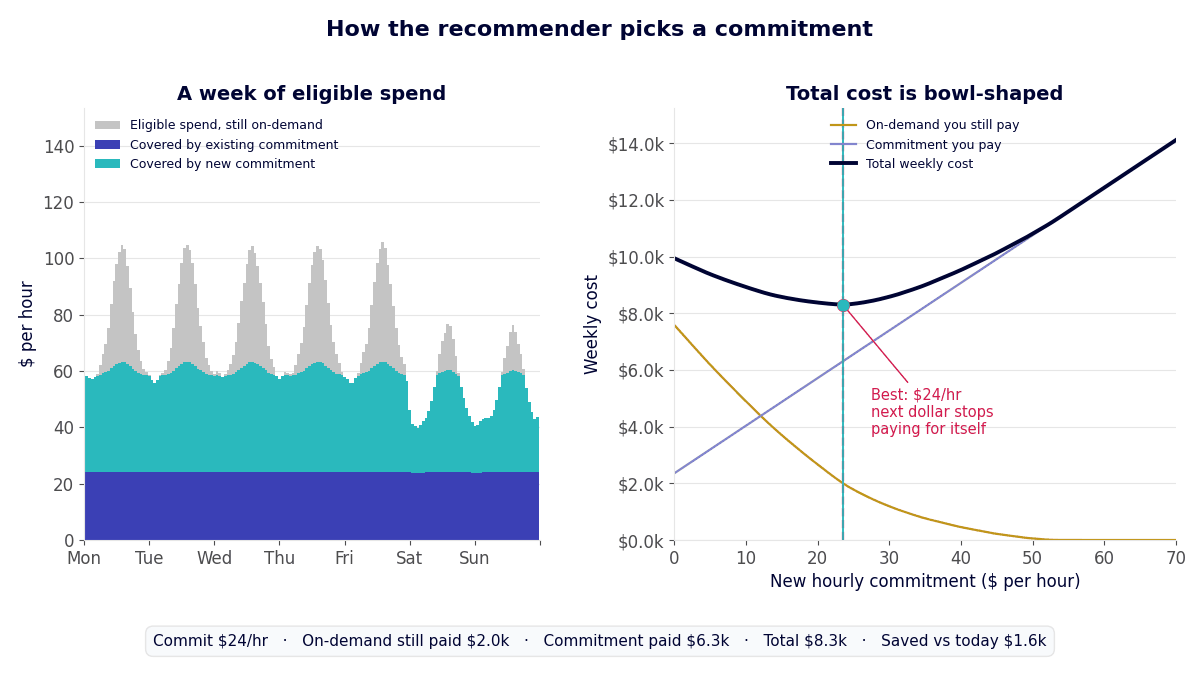
Dann wählen Sie eine Risiko-Policy: Conservative, Balanced, Max Savings – oder etwas selbst Definiertes. Jede nimmt einen Anteil dieses besten Commitments, 65 %, 80 % oder 90 %, und lässt damit Puffer für die Woche, in der Ihre Nutzung einbricht. Custom Policies gehen weiter: bis zu zehn pro Kunde, jede mit eigenem Abdeckungsziel und eigenen Kaufschritten, sodass die Empfehlung Ihren Regeln folgt statt den drei Voreinstellungen, die sich ein Cloud-Anbieter ausgedacht hat. Warum dieser Puffer wichtig ist und warum wir in Schritten kaufen statt alles auf einmal, habe ich in einem früheren Beitrag zum Sizing-Problem erläutert.
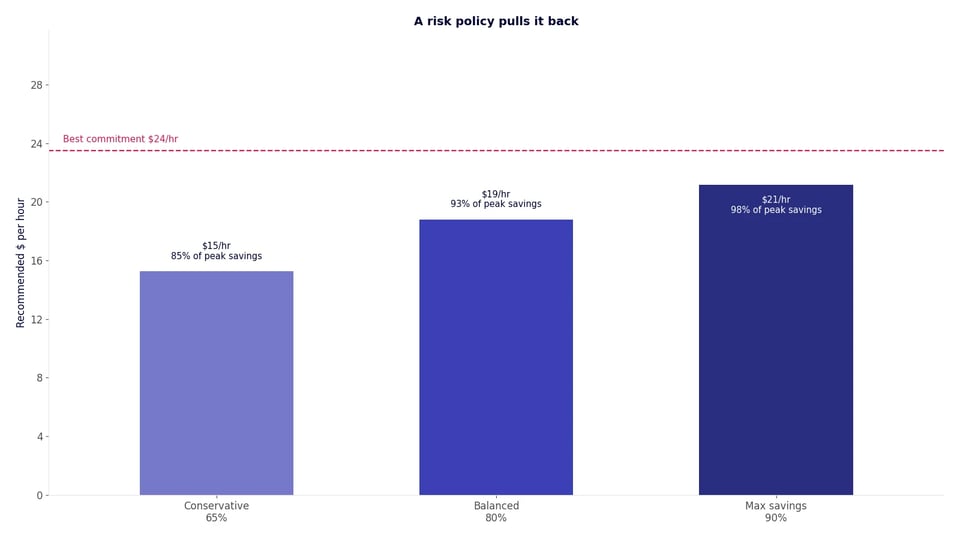
Darüber liegt eine Handvoll Stellschrauben. Wir justieren sie, wenn reale Käufe uns etwas Neues lehren. Ihre Aufgabe: die Empfehlung auf der vorsichtigen Seite des optimalen Commitment-Werts zu halten.
Manchmal wirkt der Boden der Schüssel zum Beispiel flach. Ein ganzer Bereich von Commitments – nicht eine exakte Zahl – spart fast denselben Betrag. Die reine Mathematik würde munter auf das größte zeigen, wir aber nicht. Sparen mehrere Größen ungefähr gleich viel, nehmen wir die kleinste. Gleiche Ersparnis, weniger gebundenes Geld, mehr Spielraum, falls nächsten Monat ein Workload verschwindet.
Die Stellschrauben lassen uns außerdem auf das reagieren, was wir in der Produktion sehen. Geht die Nutzung eines Accounts über das Fenster hinweg zurück, fällt die Empfehlung kleiner aus. Erweist sich ein Kauf als weniger nützlich, als das Modell erwartet hat, lernen wir daraus – und die nächste Empfehlung wird vorsichtiger.
Und weil die Engine uns gehört, können wir konkrete Kundenwünsche umsetzen – etwa "nie unter 70 % Auslastung gehen" oder "lasst extra Luft, wir konsolidieren in Q3 unsere Accounts". AWS oder Google können Sie nicht bitten, ihren Recommender mit Ihren Regeln laufen zu lassen. Uns schon – oder Sie erstellen Ihre eigene Policy, und wir befolgen sie.
Wo wir mit den Clouds übereinstimmen
Bevor wir über Unterschiede sprechen, sprechen wir über Vertrauen. Läge unsere Zahl weit von der Zahl der Cloud entfernt, dürften Sie zu Recht fragen, welche von beiden falsch ist.
Also haben wir nachgeprüft.
Eines muss zuerst stimmen, sonst ist der ganze Vergleich nur Rauschen: Beide Recommender müssen dieselben Nutzungstage betrachten. Jeder Recommender dimensioniert auf Basis eines Lookback-Fensters, eines festen Abschnitts vergangener Stunden. Bei AWS können Sie bis zu 60 Tage zurückgehen. Unseres lässt sich beliebig einstellen. Liegen die beiden Fenster auch nur ein paar Tage auseinander, weichen die Zahlen ab – und diese Differenz hat nichts mit der Methode zu tun, sondern nur mit den gewählten Tagen. Für jeden Vergleich unten haben wir unsere Engine deshalb auf exakt dieselben Start- und Enddaten gesetzt wie AWS oder Google. Gleiche Tage rein, dann vergleichen, was rauskommt.
Auf AWS haben wir unsere Engine gegen den AWS Purchase Analyzer für mehrere Accounts laufen lassen. Wir haben jede Kombination getestet: ein- und dreijährige Laufzeiten, No Upfront, Partial Upfront und All Upfront. Gleiches Lookback-Fenster auf beiden Seiten. Unser empfohlenes Commitment lag in jedem Fall innerhalb von 1 % der AWS-Zahl. Außerdem haben wir die Engine auf unserem größten AWS-Kunden laufen lassen, um sicherzugehen, dass sie auch in großem Maßstab standhält. Tut sie.
Auf Google Cloud haben wir mit den Empfehlungen aus der GCP-Konsole verglichen. Bei einem Billing-Account mit Standardpreisen stimmten wir mit Google auf den Cent überein – über alle acht getesteten Commitment-Scopes hinweg. Darunter Compute Flexible CUDs, Memorystore und Cloud SQL in jeder Region. Bei einem Account mit verhandelten Rabatten lagen wir innerhalb von 1 %.
| Cloud | Account-Typ | Getestete Scopes | Unsere Zahl vs. die der Cloud |
|---|---|---|---|
| AWS | Mittelgroßer Payer, alle Laufzeit- und Zahlungskombinationen | 6 | Innerhalb von 1 % |
| AWS | Unser größter Kunde | 6 | Läuft problemlos, innerhalb von 1 % |
| Google Cloud | Standardpreise | 8 | Exakte Übereinstimmung, auf den Cent |
| Google Cloud | Verhandelte Rabatte | 8 | Innerhalb von 1 % |
Der Punkt ist simpel: Wer dieselbe Frage stellt, bekommt dieselbe Antwort. Niemand erfindet eine größere Zahl, um Ihnen mehr zu verkaufen.
Warum also einen eigenen bauen?
Wo die Clouds aufhören und wir weitermachen
Hier die Fragen, die unsere Kunden tatsächlich stellen. In jedem Fall kann der Cloud-Recommender entweder nicht antworten – oder er lässt Sie warten. Die Kurzfassung, bevor es ins Detail geht:
| AWS | Google Cloud | DoiT | |
|---|---|---|---|
| Empfehlungsgenauigkeit | Baseline | Baseline | Innerhalb von 1 % bei beiden |
| Jede Laufzeit- und Zahlungsoption, auf Abruf | 20 Analysen pro Tag, einzeln nacheinander | Nur bestimmte Szenarien | Alle Kombinationen in unter 20 Sekunden |
| Synchrone API | Async-Job, minutenlanges Polling | Nicht verfügbar | Ja |
| Erklärt, warum sich die Zahl bewegt hat | Nein | Nein | Ja, bis hinunter zu den Abrechnungszeilen |
| Scoping nach Account oder SKU | Nein | Nein | Ja |
| Eigener Datumsbereich | Teilweise | Teilweise | Ja |
| Am Kauftag unabhängig von der Cloud-API | Nein | Nein | Ja, liest Abrechnungsdaten direkt |
| Automatisierte, gestaffelte Käufe | Nein | Nein | Ja |
| Auslaufende Commitments | Neue Empfehlung erst nach Ablauf | Neue Empfehlung erst nach Ablauf | Ersatz vor Ablauf dimensioniert und terminiert |
| Menschliche Überwachung der Auslastung | Nein | Nein | Ja, dediziertes DoiT-Team |
"Ich will 1 Jahr vs. 3 Jahre, No Upfront vs. All Upfront und drei Risikostufen vergleichen, bevor ich mich entscheide."
Auf AWS ist jede davon eine eigene Analyse. Der Purchase Analyzer erlaubt 20 Analysen pro Payer-Account und Tag. Jede dauert ein paar Sekunden bis Minuten, und sie laufen nacheinander. Um das Gesamtbild für einen Payer zu sehen, brauchen Sie mehr Analysen, als AWS an einem Tag zulässt. Also wählen Sie ein paar aus, warten und hoffen, richtig gewählt zu haben.
Google Cloud ist hier flexibler. Die Konsole lässt Sie Szenarien über verschiedene Lookback-Zeiträume bauen, und Sie können bestimmte Zeiträume ausschließen. Nützlich. Aber dort ist Schluss. Sie bekommen die Optionen, die Google eingefallen sind, zu Googles Bedingungen – und sobald Sie etwas außerhalb dieser Liste wollen, stehen Sie allein da.
Unsere Engine erzeugt jede Kombination für einen Payer-Account in unter 20 Sekunden. Und Sie können sie so oft laufen lassen, wie Sie wollen.
"Ich will Empfehlungen in mein eigenes Tooling einbinden."
Der AWS-Recommender ist ein asynchroner Job. Sie starten ihn und pollen dann, bis er fertig ist – Sekunden oder Minuten später. Darauf eine zuverlässige Pipeline zu bauen, kostet Arbeit, und das Tageslimit gilt trotzdem.
Die Empfehlung in der Google-Cloud-Konsole ist zum Lesen gedacht, nicht zum Einspeisen in einen Kauf-Workflow.
Unsere ist eine synchrone REST-API, Teil der DoiT Cloud Intelligence™ API. Sie rufen den Endpoint mit Ihrem API-Key auf und bekommen die Empfehlung in derselben Response zurück. Sie hat auf AWS und Google Cloud dieselbe Struktur, eine Integration deckt also beide ab. Sie können die tägliche Empfehlung in Slack posten, ein Ticket öffnen, wenn sie sich um mehr als einen Schwellenwert bewegt, oder sie in Ihr eigenes FinOps-Dashboard ziehen, direkt neben Ihre übrigen Kostendaten.
Und weil es eine schlichte synchrone API ist, lässt sie sich genauso leicht an einen KI-Assistenten anschließen wie an ein Dashboard. Verbinden Sie sie mit Claude – oder was immer Sie nutzen – und fragen Sie in Worten: "Wie lautet die Empfehlung für Cloud SQL in us-east1?" "Wann läuft mein nächstes Commitment aus?" "Wie viel haben uns Compute-Commitments letzten Monat gespart?" Versuchen Sie das mal bei einer Konsole.
Und alles ist vorab berechnet. Jede Option, jede Policy, jeder Account, einmal am Tag. Wenn Sie oder Ihr Assistent fragen, hängt nichts in einer Warteschlange, nichts läuft ins Rate-Limit, und es gibt keine Wartezeit pro Option. Die Antwort ist schon da.
"Warum hat sich die Zahl seit letzter Woche geändert?"
Wir haben beobachtet, wie die Empfehlung für einen AWS-Payer innerhalb einer einzigen Woche zwischen zwei recht unterschiedlichen Niveaus pendelte. Nichts in der Nutzung erklärte das. Unsere beste Erklärung: Es liegt am rollierenden Fenster und daran, an welchem Wochentag man fragt. Sicher sein können wir aber nicht, denn der Purchase Analyzer legt seinen Rechenweg nicht klar genug offen, um es zu überprüfen.
Jede Zahl, die unsere Engine produziert, lässt sich bis zu den Abrechnungszeilen zurückverfolgen. Fragt ein Kunde, warum sich die Empfehlung bewegt hat, können wir zeigen, welche Stunden sich um wie viel verändert haben. Oft ist die Antwort simpel: Ein Batch-Job läuft nachts nicht mehr, oder am Donnerstag ging eine neue Umgebung online. So oder so bekommen Sie eine Antwort statt eines Schulterzuckens.
"Dieser Account wird stillgelegt. Ignoriert ihn."
Oder: "Lasst diese SKUs weg, wir migrieren diesen Workload." Oder: "Dimensioniert auf Basis des letzten Quartals, nicht des Standardfensters."
Keine der beiden Clouds lässt Sie die Empfehlung nach Account, SKU oder einem expliziten Zeitraum eingrenzen. Sie bekommen eine Antwort für den gesamten Payer, für das Fenster, das die Cloud vorgibt.
Unsere kann alle drei. Einen Account ausschließen. Einen Anteil bestimmter SKUs herausnehmen. Eigene Start- und Enddaten setzen. Auch die Eligibility ist granular: Welche verknüpften Accounts oder Projekte überhaupt für Commitments infrage kommen, ist eine Einstellung – und die Engine dimensioniert nur gegen diese. Heute stellen wir das für Sie ein; eine Self-Service-Steuerung kommt bald. Und dahinter liegen mehr Stellschrauben, als beide Konsolen offenlegen.
Ganz offen gesagt: Heute sind das keine Self-Service-Buttons in der Konsole. Sie sagen Ihrem DoiT-Team, was ausgelassen werden soll oder welche Zeiträume gelten sollen, und wir lassen die Engine mit diesen Einstellungen für Sie laufen. Der Punkt ist, dass es überhaupt geht – und dass die Antwort noch am selben Tag zurückkommt. Und all das haben wir auf dem Radar: Wir wollen den Kunden die Stellschrauben in die Hand geben, damit sie jeden Teil selbst steuern können.
"Was, wenn der Cost Explorer am Kauftag ausfällt?"
Das klingt nach einem Randfall – bis es passiert. Ein Commitment zu dimensionieren ist keine einmalige Aufgabe. Wie ich im Beitrag zum Sizing-Problem argumentiert habe, ist es ein bewegliches Ziel, das Sie Woche für Woche neu treffen müssen, während sich Ihre Nutzung unter Ihnen verschiebt. Und das Ziel vervielfacht sich. Zwei Clouds, Compute plus Datenbank, mehrere Regionen, jede mit eigenem Commitment und eigenem Ablaufdatum. Das ist nicht eine wöchentliche Entscheidung. Es sind ein Dutzend.
Ein Recommender, der von einem externen Job abhängt, kann einen Schritt verpassen. Ist die API langsam, gedrosselt oder mitten in einem Incident, findet der Kauf dieser Woche nicht statt. Unsere Engine liest Ihre Abrechnungsdaten direkt. Es gibt nichts Externes, auf das sie warten müsste.
"Ich will das nicht ständig beaufsichtigen."
Und genau hier liegt der Kern. Das ist die eigentliche Antwort auf "Wozu brauche ich euren?".
Eine Empfehlung nützt nur, wenn jemand danach handelt. Unsere Engine speist einen automatisierten, gestaffelten Kaufprozess. Käufe laufen im Hintergrund, in einem Rhythmus, den der Kunde steuert, in Schritten, die die gewählte Policy vorgibt. Und ein dediziertes DoiT-Team überwacht die Auslastung jedes Commitments. Beginnt etwas ungenutzt zu bleiben, fängt das Team es ab, bevor es als Waste auf Ihrer Rechnung landet. Auf AWS kann das sogar heißen, einen Savings Plan zurückzugeben, solange das Rückgabefenster noch offen ist.
Auslaufende Pläne werden genauso behandelt. Steht ein Plan kurz vor dem Ende, geht die nächste Empfehlung bereits davon aus, dass er weg ist, und die Kaufstaffelung terminiert den Ersatz so, dass er genau in dem Moment startet, in dem der alte endet. Die Abdeckung sackt nicht eine Woche lang ab, bis es jemandem auffällt. Die Recommender der Clouds sehen die Lücke erst, wenn sie schon offen ist.
Bald können Kunden die Policy für den Kaufrhythmus selbst definieren – zusätzlich zur Risiko-Policy, die sie heute schon wählen.
Was heute live ist
Auf AWS deckt die Engine Compute Savings Plans und Database Savings Plans ab. Auf Google Cloud deckt sie Compute Flexible CUDs ab, die über Compute Engine und GKE hinweg gelten, sowie ausgabenbasierte Cloud SQL CUDs, die pro Region gekauft werden. Die übrigen Commitment-Typen stehen auf der Roadmap und folgen bald.
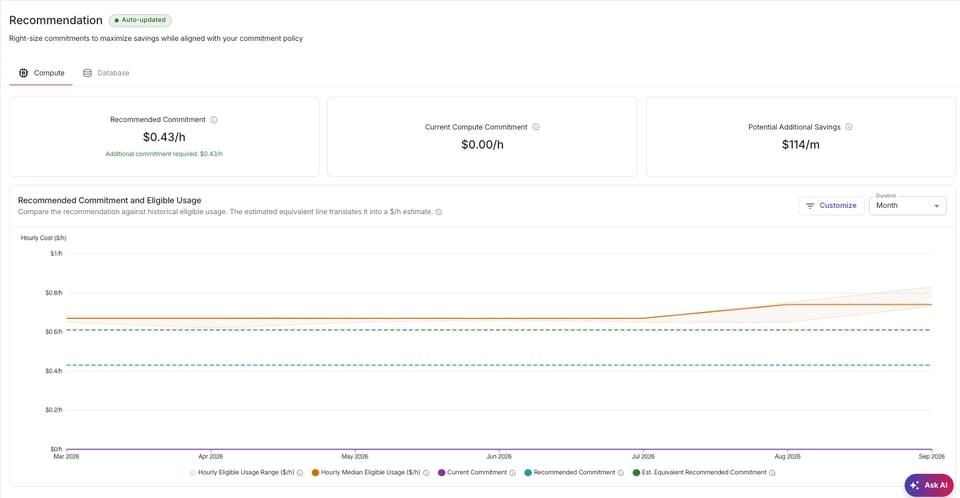
Bestehende Reserved Instances und ressourcenbasierte CUDs kaufen wir nicht für Sie. Aber die Engine kennt sie. Ausgaben, die sie bereits abdecken, sind nicht anrechenbar – wir empfehlen also kein Commitment obendrauf.
Die Policies bedeuten auf beiden Clouds dasselbe. Balanced auf AWS entspricht denselben 80 % des besten Commitments wie Balanced auf Google Cloud. Betreiben Sie beide Clouds, liest sich Ihre Commitment-Strategie auf beiden Seiten gleich.
Der Recommender läuft einmal am Tag – für jede Policy und jede Laufzeit- und Zahlungskombination, für jeden Payer-Account und Billing-Account, den wir verwalten. Wenn Sie die Konsole öffnen, stehen die Zahlen schon da.
Was als Nächstes kommt
Azure ist als Nächstes dran – dieselbe Engine und dieselben Policies werden dann alle drei großen Clouds abdecken. Der What-if-Simulator, den wir intern nutzen – Workload oder Account entfernen und zusehen, wie sich die Empfehlung vor dem Kauf bewegt –, kommt zu den Kunden. Und auf der breiteren FinOps-Seite kommt Showback nach Labels und Tags, damit Sie sehen, für welches Team oder Produkt jedes Commitment tatsächlich Geld spart.
Das Fazit
Die eingebauten Recommender von AWS und Google Cloud sind gut. Stellen wir ihnen dieselbe Frage, bekommen wir dieselbe Antwort. Wer Commitments einmal im Jahr kauft, kommt damit vermutlich aus.
Das gilt, solange Sie eine Cloud, einen Compute-Service, eine Region haben. Jetzt kommen Datenbanken dazu. Eine zweite Region. Google Cloud neben AWS. Plötzlich sind es Compute und Database Savings Plans auf der einen Seite, Compute Flexible und Cloud SQL CUDs pro Region auf der anderen – jedes mit eigenem Ablaufdatum, eigener Rabattkurve, eigenen ruhigen Stunden. Die Kombinationen vermehren sich schneller als jeder Kalender. Niemand dimensioniert das ein paarmal im Jahr von Hand. Jedenfalls nicht gut.
Aber Commitments sind kein Einmal-im-Jahr-Job. Die Nutzung wächst, schrumpft und verschiebt sich. Alte Pläne laufen aus. Neue Workloads tauchen auf. Das richtige Commitment von heute ist nicht das richtige Commitment in drei Monaten. Es ist ein bewegliches Ziel, das Sie immer wieder treffen müssen.
Dafür brauchen Sie einen Recommender, den Sie jederzeit laufen lassen, auf Ihre Situation zuschneiden, Ihrem Finance-Team erklären und einem automatisierten Kaufprozess übergeben können. Genau deshalb haben wir unseren eigenen gebaut. Er läuft jeden Tag, auf beiden Clouds, und ist jetzt live in PerfectScale for Commitments.
Wir haben ihn nicht gebaut, um AWS oder Google zu widersprechen. Wir haben ihn gebaut, damit die richtige Zahl jeden Tag erscheint, nach unserem Zeitplan, für jede Option, mit einer Begründung dazu. Und dann lassen wir die Maschine danach handeln.
Hören Sie auf, Commitments einmal im Jahr im Spreadsheet zu dimensionieren. Melden Sie sich bei uns, und wir lassen die Engine auf Ihrer echten Rechnung laufen – damit Sie sehen, wie automatisierte, risikobewusste Commitments für Sie aussehen.