


kubectl rollout は、Kubernetesがワークロードへの変更をどのようにロールアウトするかを制御・確認するためのコマンドです。Deploymentを変更すると、Kubernetesは古いPodを新しいPodに置き換えます。kubectl rollout を使えば、そのプロセスの監視、一時停止、ロールバック、再起動、そして履歴の確認ができます。
本ガイドでは、Kubernetesが内部で実際にロールアウトを実行する仕組み、kubectl rollout の全サブコマンドと使用例、ロールアウトが止まる原因と診断方法、そして本番環境で安全にロールアウトを行うためのプラクティスを解説します。
kubectl rolloutとは?
kubectl rollout は、ワークロードを変更した後のロールアウトを管理するためのコマンド群です。ロールアウトとは、旧バージョンを実行しているPodを新バージョンのPodに置き換えるプロセスを指します。このコマンド自体がワークロードを変更するわけではありません。変更によって開始されたロールアウトを観察・制御するためのもので、完了の確認、変更内容の確認、取り消し、一時停止と再開、Podの再起動が行えます。
対象となるのは、ロールアウトを自動的に管理してくれるワークロード、つまりDeployment、StatefulSet、DaemonSetです。本ガイドでは、ロールアウトが最もよく使われるDeploymentを中心に説明します。
Kubernetesはどのようにロールアウトを実行するのか
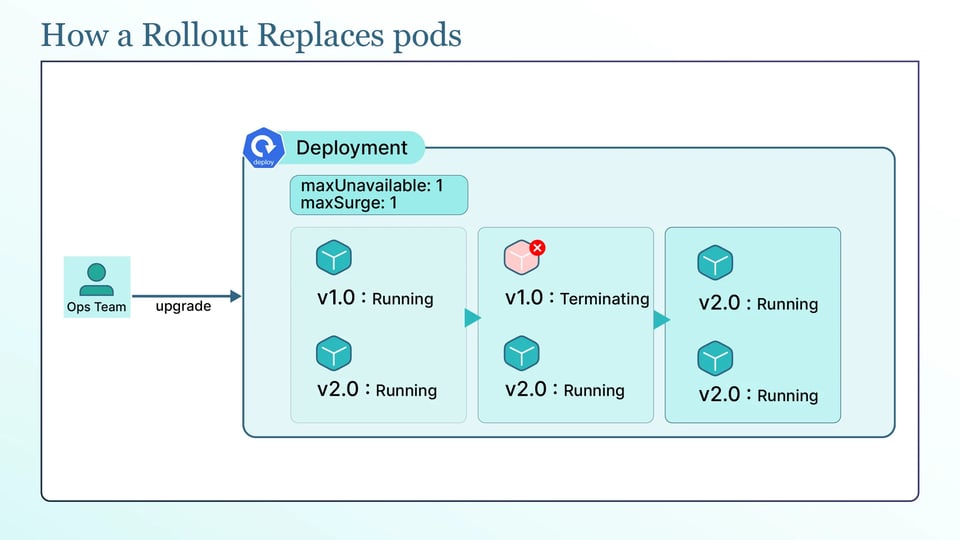
DeploymentのPodテンプレートを変更しても、Kubernetesは実行中のPodを直接編集しません。新バージョン用の新しいReplicaSetを作成し、古いReplicaSetから新しいReplicaSetへPodを段階的に移行します。各ReplicaSetとそれが所有するすべてのPodには、Podテンプレートのハッシュである pod-template-hash ラベルが付与されます。Kubernetesはこのラベルでバージョンを区別し、各Podを正しいReplicaSetに紐付けています。後でロールバックする際、Kubernetesが実際に行っているのは、古いReplicaSetを再びスケールアップすることだけです。
重要なのは、どの変更が実際にロールアウトを開始するかを知ることです。新しいReplicaSetと新しいリビジョンが作成されるのは、Podテンプレート、つまり .spec.template フィールドを変更した場合のみです。つまり、新しいイメージ、環境変数の変更、リソースリクエストの更新はすべてロールアウトをトリガーします。一方、レプリカ数の変更はロールアウトを引き起こしません。スケールアップやスケールダウンは現在のReplicaSetのサイズを変えるだけで、新しいReplicaSetを作成しないためです。Deploymentのスケーリングがロールアウト履歴に一切表示されないのはこのためです。
ロールアウトの速度は、ローリングアップデート戦略の2つのフィールドで制御されます。maxSurgeは、ロールアウト中に希望数を超えて存在できる追加Podの数を設定し、デフォルトは25%(切り上げ)です。maxUnavailableは、ロールアウト中に希望数を下回って不足してもよいPodの数を設定し、デフォルトは25%(切り捨て)です。この2つの組み合わせで、Kubernetesが古いPodを新しいPodに置き換える速さが決まります。maxSurge: 1、maxUnavailable: 0 は安全な設定としてよく使われます。古いPodを削除する前に新しいPodを1つ追加するため、フルキャパシティを下回ることがないからです。
さらに、ロールアウトの進行を制御する設定が3つあります。新しいPodは、Readinessプローブが成功して初めて利用可能(available)とみなされます。適切なReadinessプローブがなければ、Kubernetesはトラフィックを処理できる前のPodを準備完了と判断し、早すぎるタイミングで先に進んでしまいます。minReadySeconds は、Podが準備完了になった後、利用可能とカウントされるまでの待機時間を設定するもので、プローブに成功した数秒後にクラッシュするPodを検出できます。そして progressDeadlineSeconds(デフォルトは600秒=10分)は、ロールアウトが進捗しない場合に、Kubernetesが ProgressDeadlineExceeded としてDeploymentを失敗とマークするまでの待機時間です。
kubectl rolloutのサブコマンドと対応リソース
kubectl rollout には、status、history、undo、pause、resume、restart の6つのサブコマンドがあります。すべてのワークロードで使えるわけではありません。status、history、undo、restart はDeployment、StatefulSet、DaemonSetで動作します。pause と resume はDeploymentのみで動作します。一時停止できるロールアウトを持つのはDeploymentだけだからです。以下のセクションでは、api という名前のDeploymentを使って各コマンドを解説します。
kubectl rollout status
kubectl rollout status はロールアウトを追跡し、完了したタイミングを知らせてくれます:
kubectl rollout status deployment/api実行中は進捗を出力し、ロールアウトが完了すると終了します。Waiting for deployment "api" rollout to finish: 2 out of 4 new replicas have been updated... のような行が表示され、最後に deployment "api" successfully rolled out と表示されます。各行は、新しいReplicaSetがスケールアップし、Podが利用可能になっていく様子を反映しています。
デフォルトでは、このコマンドはストリーミングしながら待機します。この動作を変えるフラグが2つあります。--timeout は無限に待ち続けるのを防ぐもので、スクリプト内では重要です。--watch=false はストリーミングせず、現在のステータスを一度だけ出力して終了します:
kubectl rollout status deployment/api --timeout=5mkubectl rollout status deployment/api --watch=falserollout status の最も有用な点は終了コードです。ロールアウトが成功すると0を返し、失敗またはタイムアウトすると0以外のコードを返します。これはCI/CDパイプラインで役立ちます。kubectl apply の成功をデプロイの成功とみなすのではなく、パイプラインがロールアウトの完了を待ち、Deploymentが準備完了にならなければ失敗させることができます。
kubectl rollout history
kubectl rollout history はワークロードの過去のリビジョンを一覧表示します。何が変更されたかを確認し、ロールバック先を選ぶことができます:
kubectl rollout history deployment/api出力は、リビジョン番号とCHANGE-CAUSE列からなるテーブルです。特定のリビジョンのPodテンプレート全体を表示するには、--revision を渡します:
kubectl rollout history deployment/api --revision=2CHANGE-CAUSE列に値が入るのは、kubernetes.io/change-cause アノテーションを設定した場合のみです。以前この列を埋めるために使われていた --record フラグは非推奨になったため、現在は変更後に自分でアノテーションを設定するのが正しい方法です:
kubectl annotate deployment/api kubernetes.io/change-cause="update image to api:1.4.0"アノテーションがない場合、この列には <none> と表示され、各リビジョンで何が変わったのかを把握しにくくなります。
どこまで遡ってロールバックできるかは revisionHistoryLimit(デフォルトは10)によって決まります。Kubernetesはその数だけ古いReplicaSetを保持し、それより古いものは削除します。この上限が低すぎると、ロールバックしたいリビジョンがすでに存在しない場合があります。
kubectl rollout undo
kubectl rollout undo はワークロードをロールバックします。引数なしでは直前のリビジョンに戻り、--to-revision を指定すると履歴内の特定のリビジョンに戻ります:
kubectl rollout undo deployment/apikubectl rollout undo deployment/api --to-revision=2これが可能なのは、Kubernetesが古いReplicaSetを保持しており、それを再びスケールアップするだけだからです。ロールバック自体もロールアウトなので、続けて rollout status を実行して完了を確認しましょう。
重要な制限として、undo が復元するのはPodテンプレートのみです。これにはコンテナイメージ、環境変数、リソース設定が含まれます。Podテンプレートの外で行われた変更は元に戻りません。たとえば、リリースでConfigMap、Secret、データベーススキーマ、外部システムも変更していた場合、Deploymentをロールバックしてもそれらの変更は戻りません。
このため、rollout undo は通常のデプロイ戦略ではなく、迅速な復旧のためのツールとして扱ってください。以前のPodバージョンを素早く復元することはできますが、リリース中に変更されたすべてを元に戻せるわけではありません。
kubectl rollout restart
kubectl rollout restart は、イメージを変更せずにワークロード内のすべてのPodを再起動します:
kubectl rollout restart deployment/apiこのコマンドは、現在のタイムスタンプを持つ kubectl.kubernetes.io/restartedAt アノテーションをPodテンプレートに追加します。これによりPodテンプレートが変更されるため、Kubernetesは通常のロールアウトとして処理します。新しいReplicaSetを作成し、maxSurge、maxUnavailable、Readinessプローブに従って古いPodを段階的に置き換えます。プローブが適切に設定されていれば、ダウンタイムなしでアプリケーションを再起動できます。
よくあるユースケースは、Podを自動的に再起動しない変更を反映させることです。たとえば、アプリケーションが起動時にしか読み込まないConfigMapやSecretを更新した場合、既存のPodは古い値を使い続けます。rollout restartでPodを置き換えれば、新しい値で起動します。
rollout restartは、Podを手動で削除したりDeploymentをゼロにスケールしたりするよりも制御された方法です。Podを手動で削除しても置き換えられはしますが、同じように制御されたロールアウトプロセスにはなりません。ゼロへのスケールは、新しいPodを起動する前にすべてのPodを停止するため、ダウンタイムが発生します。rollout restartは、Deploymentのロールアウト設定に従いながらPodを段階的に置き換えます。
kubectl rollout pauseとresume
kubectl rollout pause はDeploymentへの変更の反映を一時停止し、kubectl rollout resume で再開させます:
kubectl rollout pause deployment/apikubectl rollout resume deployment/apiこれが役立つ場面は2つあります。1つ目は、複数の変更を1回のロールアウトにまとめることです。先に一時停止してから、イメージ、リソース、環境変数を変更し、その後再開すると、Kubernetesは編集ごとに個別のロールアウトを行うのではなく、すべての変更を含む1回のロールアウトを実行します:
kubectl rollout pause deployment/apikubectl set image deployment/api api=api:1.5.0kubectl set resources deployment/api -c=api --limits=cpu=500m,memory=512Mikubectl rollout resume deployment/api2つ目は、ロールアウトの途中で一時停止し、部分的なカナリアを検証することです。イメージを変更してロールアウトを開始し、新しいPodがいくつか起動したところで一時停止します。この時点でトラフィックの一部が新バージョンに流れ、残りは旧バージョンにとどまるため、メトリクスやログを観察できます。問題がなければ再開してロールアウトを完了し、問題があればundoでロールバックします。一時停止中のDeploymentはロールバックできないため、undo を実行する前に再開する必要がある点に注意してください。
ロールアウトが止まる原因と診断方法
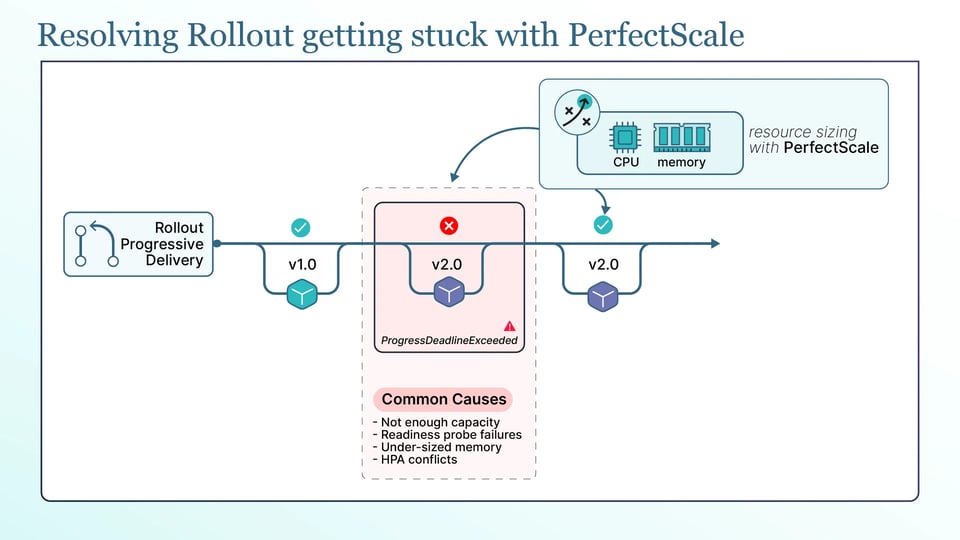
ロールアウトは、新しいPodが利用可能にならないと停止し、最終的にDeploymentは ProgressDeadlineExceeded を報告します。よくある原因は以下のとおりです:
a. サージPod用のクラスタ容量不足:ローリングアップデートは、古いPodを削除する前に追加のPod(maxSurge)を作成するため、それらをスケジュールするための余剰のCPUとメモリが必要です。クラスタに空きがなければ、サージPodは Pending のままとなり、ロールアウトは進みません。kubectl get pods と、PendingのPodに対する kubectl describe pod で状況を確認し、Cluster Autoscalerがノードを追加できるかを確認してください。
b. Readinessプローブの失敗とCrashLoopBackOff:新しいPodが起動してもReadinessプローブに一度も成功しない、あるいはクラッシュと再起動を繰り返す場合、そのPodは利用可能とカウントされず、ロールアウトは停滞します。kubectl logs で新しいPodのログを、kubectl describe pod でイベントを確認してください。プローブの設定ミスや問題のある新イメージはここで見つかります。
c. メモリのリクエストと上限の設定不足によるOOMKill:新バージョンが上限を超えるメモリを必要とする場合、起動のたびにカーネルが新しいPodを強制終了するため、Podは終了コード137とともに OOMKilled と表示され、ロールアウトは完了しません。コンテナはクラッシュしたのではなく強制終了されたため、Pod自身のログは通常空です。手がかりは kubectl describe pod のlast stateにあります。
d. PodDisruptionBudgetはロールアウト自体をブロックしない:PodDisruptionBudgetは、Deploymentのローリングアップデートを制約しません。ロールアウトはEviction APIを経由せずPodを直接置き換えるため、PDBはワークロードのローリングアップデートを制限しないのです。PDBが制約するのは自発的なEviction、つまりノードのdrain、Cluster Autoscalerのスケールダウンなどです。したがって、ロールアウトと同時に発生しているノードのdrainをPDBがブロックすることはあり、不適切に設定されたPDB(たとえば minAvailable がレプリカ数と同じ)はdrainを完全にブロックしますが、ロールアウト自体を止めているのはPDBではありません。
e. Horizontal Pod Autoscalerとレプリカ数の競合:HPAがDeploymentのレプリカ数を管理しているにもかかわらず、マニフェストにも replicas をハードコードしていると、kubectl apply のたびにレプリカ数がマニフェストの値にリセットされ、HPAが再び修正するまでその状態が続きます。これはロールアウト中に混乱を招くスケーリングを引き起こします。解決策は、HPAが管理するDeploymentのマニフェストから replicas を削除することです。
これらの問題の多くは、リソースサイジングに行き着きます。クラスタに収まらないサージPodも、OOMKilled される新しいPodも、いずれもリソース設定の誤りを示しています。ここで役立つのがPerfectScaleです。PerfectScaleのKubernetesガバナンスプラットフォームは、ワークロードが実際にCPUとメモリをどう使っているかを監視し、それを実践的で自動化されたライトサイジングの推奨事項に落とし込みます。推奨は手動でも自律的にも適用できます。リクエストと上限が実態に合っていれば、サージPodは収まり、新しいPodには必要なメモリが確保されるため、ロールアウトは途中で止まることなくスムーズに完了します。Paramount PicturesやCreditasといったチームがPerfectScaleを活用してクラスタの効率を維持しています。ぜひサインアップするか、技術セッションを予約してみてください。
本番環境でkubectl rolloutを運用するベストプラクティス
本番環境のロールアウトを安全かつスムーズに保つためのシンプルなプラクティスをいくつか紹介します:
a. ロールアウト前にリクエストと上限をライトサイジングする:ロールアウトを開始する前に、正確なリソースリクエストと上限を設定してください。これにより、サージPodをスケジュールする余裕が生まれ、新しいPodがOOMKilledされるリスクが減ります。
b. rollout statusだけでなくメトリクスとログも確認する:rollout statusの成功は、新しいPodが準備完了になったことを意味するだけです。アプリケーションが正しく動作していることの保証にはなりません。ロールアウト後、特に一時停止したカナリアを使っている場合は、エラー率、レイテンシ、ログを確認すべきです。
c. progressDeadlineSecondsと--timeoutを明示的に設定する:Kubernetesが停止したDeploymentを失敗とマークできるよう、適切なprogressDeadlineSecondsを設定してください。rollout statusには--timeoutを付け、パイプラインが一定時間後に待機をやめるようにします。
d. すべての変更にchange-causeアノテーションを付ける:変更時にkubernetes.io/change-causeを設定すれば、rollout historyで各リビジョンの変更内容が明確に分かるようになります。ロールバック時に正しいリビジョンを選びやすくなります。
e. 安全にロールバックできるだけの revisionHistoryLimit を確保する:デフォルトの10はほとんどのワークロードで十分ですが、デプロイ頻度が非常に高い場合は、現実的に戻る可能性のあるリビジョンをカバーできているか確認してください。
f. 段階的なロールアウトで影響範囲を限定する:リスクのある変更をすべてのネームスペースやクラスタに一度に送るのは避けましょう。段階的にロールアウトすれば、問題を早期に発見し、全体に影響が及ぶ前に止められます。
g. 手動コマンドからGitOpsとプログレッシブデリバリーへ移行する:kubectl rolloutは、ロールアウトを学び、手動で管理するのに便利です。より大規模な本番環境では、Argo CDやFluxのようなツールでGitOpsによるデプロイ管理を行い、Argo RolloutsやFlaggerでカナリアデプロイやブルーグリーンデプロイを自動化できます。